Da parecchio tempo cerco una buona soluzione per utilizzare PostgreSQL nel cloud.
PostgreSQL è praticamente il mio cavallo di battaglia. Lo utilizzo in tantissimi progetti, lo conosco bene e, sinceramente, non ho nessuna voglia di sostituirlo.
Mi è sempre piaciuta anche la comodità dei servizi gestiti. Creo un database, collego l'applicazione e posso tornare a programmare. Non devo pensare continuamente ai backup, agli aggiornamenti del server, alle configurazioni e a tutto quello che comporta mantenere un PostgreSQL in produzione.
Anche perché di progetti ne ho già parecchi. Alcuni sono piccoli, altri crescono, altri sono ancora esperimenti. E quando lavoro a una nuova idea voglio poterla lanciare senza passare tre giorni a configurare l'infrastruttura.
Il problema è che, mentre crescono i progetti, cresce anche il billing.
E soprattutto cresce quello dei database.
Ho provato diversi provider, tra cui Fly.io, e ho guardato parecchie alternative. Ogni volta sembra di ritrovarsi davanti alla stessa storia: parti da un piano che sembra ragionevole, poi aumenti un po' le risorse, aggiungi un altro progetto, magari hai bisogno di un database separato...
Ed ecco un altro abbonamento.
A un certo punto ho cominciato a pensare che tutti i provider PostgreSQL si fossero messi d'accordo per alzare i prezzi.
Naturalmente scherzo. Però guardando certi listini, il dubbio viene.
Ma quanto costa oggi un PostgreSQL?
Ho raccolto alcuni prezzi di partenza dei servizi più conosciuti, aggiornati a ottobre 2026.
| Provider | Prezzo indicativo |
|---|---|
| Fly.io Managed Postgres | Da 38 $/mese, storage escluso |
| Supabase Pro | Da 25 $/mese, primo progetto incluso |
| DigitalOcean Managed PostgreSQL | Da 15 $/mese per un nodo base |
| Render PostgreSQL | Da 6 $/mese per 256 MB; 19 $ per 1 GB di RAM |
| Hetzner Cloud CAX21 | 10,49 €/mese per una VPS ARM64, IVA ed extra esclusi |
L'ultima riga non è un database gestito: Hetzner fornisce il server su cui installarlo. L'ho messa apposta, perché è proprio da questo confronto che è partita la mia decisione.
E comunque, guardate quei prezzi.
Ma è possibile che per salvare due righe in croce su PostgreSQL debba spendere così tanto?
Non sto chiedendo una GPU per addestrare un modello AI. Voglio salvare degli utenti, qualche configurazione, messaggi, documenti e magari un po' di dati applicativi.
Spesso un progetto è ancora in sviluppo e non ha nemmeno utenti veri. Ma il database intanto costa.
Capisco che i servizi gestiti includano backup automatici, aggiornamenti, alta disponibilità e tante altre comodità. Non sto dicendo che non abbiano valore.
Però mi capita anche di confrontarli con altri servizi cloud, comprese diverse soluzioni AWS, e vedere differenze di prezzo enormi. Certo, bisogna confrontare risorse, affidabilità e funzionalità equivalenti, altrimenti i numeri significano poco.
Ma il mio problema rimane lo stesso: perché devo continuare ad aggiungere un costo fisso così alto ogni volta che voglio provare una nuova applicazione?
Se un prodotto comincia a generare entrate, spendere qualcosa in più per un'infrastruttura gestita può avere perfettamente senso.
Quando invece stai ancora cercando di capire se qualcuno lo utilizzerà, quei costi cominciano a pesare parecchio.
E io di progetti da provare ne ho già abbastanza.
Alla fine ho deciso di utilizzare un server mio
Dopo anni passati a utilizzare e provare database gestiti, ho deciso di cambiare.
Ho preso un server Hetzner e ho iniziato a organizzare lì PostgreSQL e i database delle mie applicazioni.
E devo dire che, per adesso, non me ne sono pentito.
Nel mio caso spendo all'incirca 20 dollari al mese per la configurazione che sto utilizzando, con risorse che considero più che sufficienti: circa 8 core, 24 GB di RAM e spazio disco per i miei progetti.
Naturalmente parlo della mia configurazione e della mia spesa, non di un'offerta standard valida per tutti. I piani e i prezzi cambiano.
La cosa che mi interessa è che adesso posso decidere io come distribuire quelle risorse.
Posso creare diversi database PostgreSQL sulla stessa istanza, dare a ogni applicazione il proprio utente e i propri permessi, e aumentare le risorse della macchina quando servirà davvero.
Senza acquistare automaticamente un nuovo database gestito per ogni idea che mi viene.
Però c'era ancora qualcosa che non mi piaceva.
Il terminale.
Non fraintendetemi, ci lavoro tutti i giorni. Ma quando devo aggiungere un database, creare un ruolo, verificare le connessioni o controllare i backup, non ho voglia di entrare ogni volta in SSH e ricordarmi tutti i comandi.
Vorrei aprire una pagina, vedere i miei database e fare quello che mi serve.
Non mi sembra una richiesta particolarmente assurda.
Così ho cominciato a cercare una soluzione che mi permettesse di utilizzare PostgreSQL sul mio server, ma senza perdere tutta la comodità di una piattaforma gestita.
Ed è così che ho trovato Supavisor.
La parte divertente è che è scritto in Elixir.
Finalmente qualcosa che potevo aprire, leggere e modificare usando il mio linguaggio preferito.
Che cos'è Supavisor?
Supavisor è un connection pooler open source sviluppato da Supabase.
Non è un database. PostgreSQL continua a conservare i dati e a eseguire le query.
Supavisor si occupa di gestire le connessioni tra le applicazioni e PostgreSQL.
Per esempio:
Applicazione Elixir ──┐
                      │
Applicazione Node.js ─┼── Supavisor ── PostgreSQL
                      │                    │
Applicazione Python ──┘              ┌─────┼─────┐
                                    DB A  DB B  DB C
La cosa comoda è che Supavisor parla il normale protocollo PostgreSQL.
Quindi posso utilizzare Ecto, Postgrex, psql, psycopg, il driver PostgreSQL di Node.js e praticamente qualsiasi altro client compatibile.
Non devo introdurre un'API HTTP per eseguire una SELECT.
Supavisor offre principalmente due modalità di pooling.
Session pooling: una connessione PostgreSQL rimane assegnata al client per tutta la sua sessione.
Transaction pooling: la connessione PostgreSQL viene assegnata al client durante una transazione e poi può essere riutilizzata.
La seconda modalità è particolarmente interessante quando ho tante applicazioni o istanze che mantengono connessioni aperte, ma lavorano sul database soltanto per brevi periodi.
Per esempio, cinque istanze Phoenix con pool_size: 10 possono arrivare ad aprire 50 connessioni. Con Supavisor posso controllare separatamente quante connessioni backend vengono mantenute verso PostgreSQL.
Naturalmente non significa che 50 query possano essere eseguite contemporaneamente attraverso cinque connessioni senza aspettare. Se il pool è occupato, i client aspettano.
Il vantaggio è evitare di tenere troppe connessioni PostgreSQL inutilizzate.
Colleghiamo un database a Supavisor
Nel mio fork utilizzo queste porte:
5432  PostgreSQL diretto
6543  Transaction pooling
5452  Session pooling
4000  Dashboard Phoenix
Supponiamo di avere un database chiamato demo_db, con un ruolo PostgreSQL chiamato demo_app.
Se il database non esiste ancora, possiamo crearlo manualmente:
sudo -u postgres createuser \
  --login \
  --pwprompt \
  demo_app

sudo -u postgres createdb \
  --owner=demo_app \
  demo_db
In Supavisor creiamo un tenant, cioè un profilo di connessione che identifica il database, le credenziali e la configurazione del pool.
Per il nostro esempio:
Tenant:       demo
Database:     demo_db
Host:         127.0.0.1
Port:         5432
Database user: demo_app
Pool size:    5
Max clients:  50
Il nome utente per collegarsi attraverso Supavisor è composto dal ruolo PostgreSQL e dal tenant:
demo_app.demo
Possiamo provare con psql:
psql \
  -h 127.0.0.1 \
  -p 6543 \
  -U demo_app.demo \
  -d demo_db \
  -W
Inseriamo la password configurata per il ruolo.
Se tutto è corretto:
SELECT current_database(), current_user;
E siamo collegati attraverso il pooler.
Fin qui non abbiamo cambiato assolutamente nulla nel modo in cui utilizziamo PostgreSQL.
E da Elixir? Basta configurare Ecto
Una volta configurato Supavisor sul server, l'applicazione si collega direttamente all'hostname del pooler. È lo stesso approccio che utilizzo nelle mie applicazioni: host, porta e certificato TLS arrivano dalle variabili d'ambiente. Non serve creare un tunnel SSH e non devo cambiare le query Ecto.
Supponiamo di aver creato il tenant demo per il database demo_db, con l'utente PostgreSQL demo_app. Il nome utente da usare sul pooler è demo_app.demo. In config/runtime.exs posso configurare il repository così:
# config/runtime.exs
import Config

if config_env() == :prod do
  hostname = System.fetch_env!("DATABASE_HOSTNAME")
  pool_mode = System.get_env("DATABASE_POOL_MODE", "transaction")

  {port, prepare} =
    case pool_mode do
      "transaction" -> {6543, :unnamed}
      "session" -> {5452, :named}
      other -> raise "Unsupported pool mode: #{other}"
    end

  config :demo, Demo.Repo,
    hostname: hostname,
    port: port,
    database: System.fetch_env!("DATABASE_NAME"),
    username: System.fetch_env!("DATABASE_USERNAME"),
    password: System.fetch_env!("DATABASE_PASSWORD"),
    pool_size: String.to_integer(System.get_env("POOL_SIZE", "5")),
    prepare: prepare,
    connect_timeout: 30_000,
    show_sensitive_data_on_connection_error: false,
    ssl: [
      verify: :verify_peer,
      cacertfile: System.fetch_env!("DATABASE_CA_CERT_FILE"),
      server_name_indication: String.to_charlist(hostname)
    ]
end
Per esempio, sul server che ospita Phoenix imposto DATABASE_HOSTNAME=db.example.com, DATABASE_NAME=demo_db, DATABASE_USERNAME=demo_app.demo e DATABASE_POOL_MODE=transaction. La password rimane in un secret. DATABASE_CA_CERT_FILE indica il file PEM delle CA fidate che validano il certificato TLS del pooler. Se uso una CA privata, devo distribuire la sua CA ai client; se uso un certificato pubblico, posso usare un bundle di CA attendibili.
Il dominio deve corrispondere al certificato del server. Con verify: :verify_peer non voglio una connessione semplicemente cifrata: voglio anche verificare a quale server mi sto collegando.
Una volta avviata l'applicazione, posso controllare la connessione direttamente da IEx:
Ecto.Adapters.SQL.query!(
  Demo.Repo,
  "SELECT current_database(), current_user",
  []
)
Questa configurazione parla direttamente con Supavisor sulla porta 6543. Per le migration seleziono DATABASE_POOL_MODE=session e uso la porta 5452. Entrambe sono sul server remoto, senza porte locali aggiuntive.
Perché prepare: :unnamed?
Questo dettaglio è importante.
Nel transaction pooling, due transazioni consecutive possono utilizzare connessioni PostgreSQL differenti.
Se un client prepara uno statement con un nome su una connessione, non può automaticamente aspettarsi che quello statement esista sulla connessione successiva.
Configurando Postgrex con:
prepare: :unnamed
evitiamo di dipendere da prepared statement persistenti associati a una singola sessione.
Supavisor può supportare anche prepared statement con nome in transaction mode, ma richiede l'abilitazione e la configurazione della funzionalità dedicata. Preferisco utilizzare la modalità più semplice finché non mi serve altro.
Non funziona soltanto con Elixir
Supavisor utilizza il normale protocollo PostgreSQL, quindi possiamo collegarci direttamente anche da altri linguaggi. Servono lo stesso dominio, la porta del pooler, il nome utente ruolo.tenant e una connessione TLS che verifichi il certificato.
Per Node.js, per esempio, installiamo pg:
npm install pg
const fs = require("node:fs");
const { Client } = require("pg");

async function main() {
  const db = new Client({
    host: process.env.DATABASE_HOSTNAME,
    port: 6543,
    user: "demo_app.demo",
    password: process.env.DATABASE_PASSWORD,
    database: "demo_db",
    ssl: {
      ca: fs.readFileSync(
        process.env.DATABASE_CA_CERT_FILE,
        "utf8"
      ),
      rejectUnauthorized: true
    }
  });

  await db.connect();
  const result = await db.query("SELECT 1 AS ok");
  console.log(result.rows);
  await db.end();
}

main().catch(console.error);
Da Python con psycopg, invece:
pip install "psycopg[binary]"
import os
import psycopg

with psycopg.connect(
    host=os.environ["DATABASE_HOSTNAME"],
    port=6543,
    dbname="demo_db",
    user="demo_app.demo",
    password=os.environ["DATABASE_PASSWORD"],
    sslmode="verify-full",
    sslrootcert=os.environ["DATABASE_CA_CERT_FILE"]
) as connection:
    with connection.cursor() as cursor:
        cursor.execute("SELECT current_database()")
        print(cursor.fetchone())
Tutti e tre gli esempi, Elixir, Node.js e Python, raggiungono direttamente lo stesso Supavisor. Non c'è un servizio HTTP intermedio e non c'è bisogno di un tunnel SSH.
Però io volevo soprattutto una dashboard
E qui arriviamo alla parte per cui ho modificato il progetto.
Supavisor nasce come connection pooler. Io volevo anche un modo semplice per amministrare i database dal browser.
Ho creato quindi il mio fork e ho aggiunto una console con Phoenix LiveView.
Il codice è pubblico:
Supavisor con dashboard (elchemista/supavisor)
La dashboard permette di vedere i tenant, aggiungere e modificare profili di connessione, consultare i database PostgreSQL, amministrare gli accessi e controllare le metriche.
Ho aggiunto anche operazioni di backup e ripristino.
Una funzione che trovo particolarmente comoda è il provisioning: posso creare un nuovo database, il suo ruolo PostgreSQL e il tenant Supavisor direttamente dalla console.
Questa funzione è disabilitata per impostazione predefinita, perché richiede credenziali amministrative sul server PostgreSQL. Va abilitata esplicitamente e limitata ai server autorizzati.
Altrimenti posso continuare a collegare database e ruoli già esistenti.
La differenza per me è enorme: invece di ricordarmi ogni volta comandi SQL e parametri, posso aprire il browser e fare le operazioni più comuni.
Poi, mentre lavoravo alla dashboard, ho cominciato ad aggiungere anche altre cose.
API REST e WebSocket, integrazione per embedding locali tramite ExFastembed, servizi email e alcune funzionalità AI.
Lo so. Dovevo soltanto aggiungere una dashboard PostgreSQL.
A quanto pare non sono molto bravo a fermarmi.
Ma questa è anche una delle cose che mi piacciono dell'open source: se uno strumento fa quasi tutto quello che mi serve, posso modificarlo e adattarlo alle mie esigenze.
Provarlo in locale
Per provare il mio fork servono PostgreSQL già funzionante, Elixir 1.19 o superiore, Erlang/OTP 27 o superiore e le dipendenze native della build.
Cloniamo il branch della dashboard:
git clone --branch ui/admin \
  https://github.com/elchemista/supavisor.git

cd supavisor
Poi:
mix setup
mix phx.server
Apriamo:
http://localhost:4000/admin
In sviluppo, la console permette l'accesso locale con admin@localhost usando il pulsante Sign in locally.
Il comando mix setup prepara le dipendenze, crea il database dei metadati necessario e applica le migration del progetto. Non deve essere confuso con un reset dei database delle nostre applicazioni.
Da qui possiamo provare la console e aggiungere i tenant di cui abbiamo bisogno.
Installarlo su un server Hetzner
Per il deploy ho preferito utilizzare una normale release Elixir con systemd.
Naturalmente questo esempio presuppone un server Ubuntu già preparato e accessibile via SSH, con PostgreSQL installato, e le versioni richieste di Elixir, Erlang e Rust.
Per gli strumenti di amministrazione di base:
sudo apt update

sudo apt install -y \
  postgresql \
  postgresql-client \
  nginx \
  certbot \
  python3-certbot-nginx \
  ufw
Per prima cosa preparo un ruolo PostgreSQL e un database dedicati ai metadati di Supavisor:
sudo -u postgres createuser \
  --login \
  --pwprompt \
  supavisor

sudo -u postgres createdb \
  --owner=supavisor \
  supavisor
Il ruolo che utilizza Supavisor per i propri metadati non deve essere un superuser.
L'eventuale account che gestisce la creazione di database e ruoli dal pannello è un'altra cosa, con privilegi separati e da proteggere con attenzione.
Compilare la release
Nel repository ho preparato uno script:
./scripts/build-release.sh
Lo script compila il progetto, prepara gli asset LiveView e crea una release Elixir di produzione.
Il risultato viene generato in:
_build/prod/rel/supavisor
La release va compilata per un sistema compatibile con quello di destinazione. Per esempio, non posso prendere una build x86_64 e copiarla su un server ARM64 aspettandomi che funzioni.
Creo quindi un utente Linux dedicato:
sudo adduser --system \
  --group \
  --home /var/lib/supavisor \
  supavisor
E installo la release:
sudo mkdir -p /opt/supavisor

sudo cp -a \
  _build/prod/rel/supavisor \
  /opt/supavisor/current

sudo chown -R \
  supavisor:supavisor \
  /opt/supavisor/current
Configurare Supavisor
La configurazione di produzione viene letta da:
/etc/supavisor/supavisor.env
Il repository contiene già un template:
deploy/systemd/supavisor.env.example
Possiamo copiarlo:
sudo install -d -m 700 /etc/supavisor

sudo install -m 600 \
  deploy/systemd/supavisor.env.example \
  /etc/supavisor/supavisor.env

sudoedit /etc/supavisor/supavisor.env
Tra i parametri più importanti troviamo:
PORT=4000

HTTP_BIND_ADDRESS=127.0.0.1
PROXY_BIND_ADDRESS=127.0.0.1

PROXY_PORT_TRANSACTION=6543
PROXY_PORT_SESSION=5452

ADMIN_BASE_URL=https://db.example.com
POOLER_HOST=db.example.com

ADMIN_EMAILS=admin@example.com

CLUSTER_POSTGRES=false
ADMIN_PROVISIONING_ENABLED=false
Nel file reale dobbiamo configurare anche DATABASE_URL per il database dei metadati, SECRET_KEY_BASE, VAULT_ENC_KEY, i segreti JWT e gli altri parametri richiesti dal template.
Per generare alcuni di questi valori:
# Chiave Vault: 32 caratteri esadecimali
openssl rand -hex 16

# Secret di Phoenix
openssl rand -hex 64

# Altri secret casuali
openssl rand -hex 32
Non vanno copiati i segreti di esempio di sviluppo.
La chiave VAULT_ENC_KEY, in particolare, va conservata: se la perdiamo, le credenziali cifrate salvate da Supavisor potrebbero non essere più recuperabili.
Avviarlo con systemd
Nel repository c'è già un'unità systemd:
deploy/systemd/supavisor.service
La installiamo:
sudo cp \
  deploy/systemd/supavisor.service \
  /etc/systemd/system/

sudo systemctl daemon-reload

sudo systemctl enable --now supavisor
Per controllare:
sudo systemctl status supavisor

sudo journalctl -u supavisor -f
L'unità esegue le migration dei metadati prima dell'avvio dell'applicazione.
Il database supavisor deve quindi esistere già e le credenziali configurate devono funzionare.
Firewall: connessione diretta sì, accesso pubblico a tutti no
Per utilizzare Supavisor da un altro server non devo aprire PostgreSQL al mondo intero. Voglio rendere raggiungibili soltanto le porte del pooler e soltanto dagli IP autorizzati. La dashboard Phoenix continua ad ascoltare su 127.0.0.1:4000, dietro Nginx e HTTPS.
Per evitare di esporre il pooler prima di aver configurato la rete, lascio inizialmente PROXY_BIND_ADDRESS=127.0.0.1. Prima di cambiarlo, preparo il firewall. In questo esempio 198.51.100.10 è un indirizzo fittizio: va sostituito con l'IP pubblico di uscita del server applicativo.
sudo ufw allow OpenSSH
sudo ufw allow 80/tcp
sudo ufw allow 443/tcp

sudo ufw allow from 198.51.100.10 to any port 6543 proto tcp
sudo ufw allow from 198.51.100.10 to any port 5452 proto tcp

sudo ufw default deny incoming
sudo ufw default allow outgoing
sudo ufw enable
sudo ufw status verbose
PostgreSQL sulla porta 5432 rimane privato. Anche le porte interne di Supavisor, tra cui 5412 e 12100 fino a 12107, non devono diventare pubbliche. Se ho un'interfaccia di rete privata dedicata posso preferire quella al bind su tutte le interfacce.
Per la console web utilizzo Nginx. Una configurazione HTTP minimale, prima di attivare il certificato, è questa:
server {
    listen 80;
    server_name db.example.com;

    location / {
        proxy_pass http://127.0.0.1:4000;
        proxy_http_version 1.1;

        proxy_set_header Host $host;
        proxy_set_header X-Forwarded-Proto $scheme;
        proxy_set_header X-Forwarded-For $proxy_add_x_forwarded_for;

        proxy_set_header Upgrade $http_upgrade;
        proxy_set_header Connection "upgrade";

        proxy_read_timeout 3600;
    }
}
Dopo aver configurato DNS e virtual host, verifico Nginx e attivo HTTPS:
sudo nginx -t
sudo systemctl reload nginx

sudo certbot --nginx -d db.example.com
A questo punto posso usare il certificato anche per il listener PostgreSQL di Supavisor. Il servizio gira come utente non privilegiato, quindi non gli darei accesso indiscriminato alla directory privata di Certbot. Copio certificato e chiave in una directory dedicata con permessi appropriati:
sudo install -d -m 750 -o root -g supavisor /etc/supavisor/tls

sudo install -m 644 -o root -g supavisor \
  /etc/letsencrypt/live/db.example.com/fullchain.pem \
  /etc/supavisor/tls/fullchain.pem

sudo install -m 640 -o root -g supavisor \
  /etc/letsencrypt/live/db.example.com/privkey.pem \
  /etc/supavisor/tls/privkey.pem
Nell'ambiente di Supavisor abilito quindi il listener verso la rete e indico i certificati. Lo faccio solo dopo aver verificato le regole firewall:
PROXY_BIND_ADDRESS=0.0.0.0
PROXY_PORT_TRANSACTION=6543
PROXY_PORT_SESSION=5452

GLOBAL_DOWNSTREAM_CERT_PATH=/etc/supavisor/tls/fullchain.pem
GLOBAL_DOWNSTREAM_KEY_PATH=/etc/supavisor/tls/privkey.pem

TRUST_PROXY_HEADERS=true
Il valore 0.0.0.0 espone i listener IPv4 su tutte le interfacce. Per questo il firewall è fondamentale: soltanto gli IP consentiti devono raggiungere le porte 6543 e 5452. TRUST_PROXY_HEADERS=true riguarda invece la console web dietro il reverse proxy locale e va abilitato soltanto se Nginx sostituisce gli header inoltrati.
Riavvio Supavisor e verifico il servizio:
sudo systemctl restart supavisor
sudo systemctl status supavisor
sudo ufw status verbose
Il certificato copiato deve essere aggiornato anche ai rinnovi di Certbot, per esempio con un deploy hook che ricopi i file, controlli i permessi e riavvii Supavisor. Il browser utilizza HTTPS tramite Nginx, mentre Ecto e gli altri client usano direttamente il protocollo PostgreSQL cifrato sulle porte del pooler.
Se l'applicazione è ospitata su una piattaforma con IP di uscita variabili, prima di aprire una porta a un'intera rete valuterei una rete privata, una VPN o un indirizzo di egress stabile.
Come effettuare il primo login alla dashboard
In sviluppo l'accesso locale è comodo, ma ovviamente non voglio che chiunque possa aprire la dashboard in produzione.
Nel mio fork ho aggiunto un sistema di autorizzazione amministrativa.
La console permette di utilizzare email e password e, facoltativamente, il login tramite GitHub OAuth.
In produzione non esiste una registrazione pubblica degli amministratori.
L'elenco degli indirizzi autorizzati viene configurato inizialmente con:
ADMIN_EMAILS=admin@example.com
Dopo il primo avvio, per una nuova installazione possiamo generare dal server un link monouso che permette all'amministratore autorizzato di impostare la propria password.
Con il servizio già attivo:
sudo systemd-run --wait --pipe --collect \
  -p User=supavisor \
  -p Group=supavisor \
  -p WorkingDirectory=/opt/supavisor/current \
  -p EnvironmentFile=/etc/supavisor/supavisor.env \
  /opt/supavisor/current/bin/supavisor rpc \
  '{:ok, url} = SupavisorWeb.AdminAuth.create_magic_link("admin@example.com"); IO.puts(url)'
Il link va aperto privatamente. Scade dopo 15 minuti e può essere utilizzato una sola volta.
Da lì imposto una password e posso entrare normalmente nella dashboard. Non è necessario configurare SMTP per utilizzare il login con password.
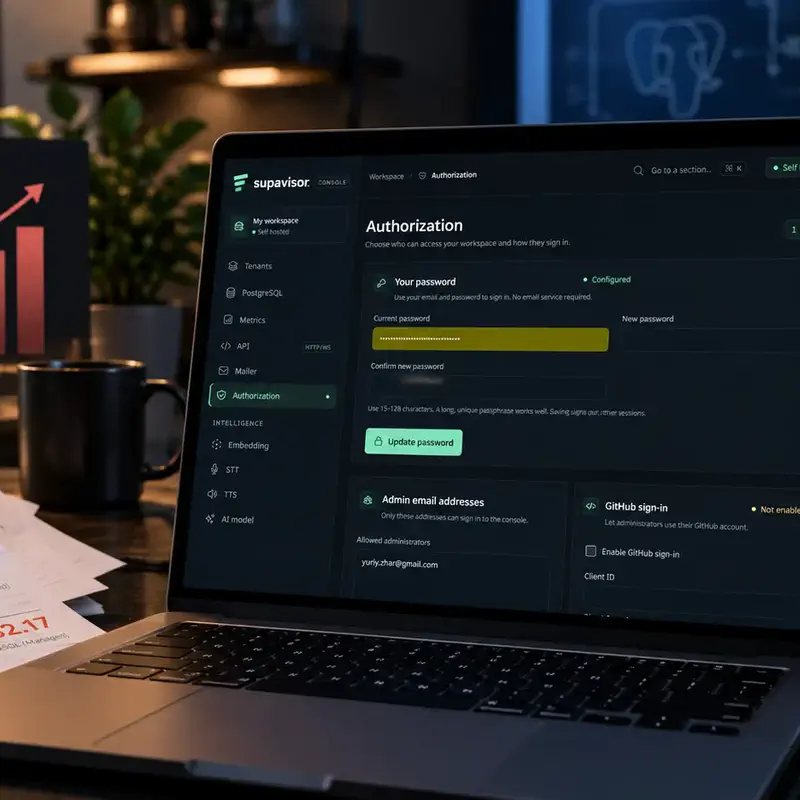
Nella pagina Authorization, quella che ho aggiunto con LiveView, posso poi gestire la password, controllare gli indirizzi amministrativi autorizzati e configurare eventualmente GitHub come metodo di accesso.
Se dimentico la password, il repository include anche uno strumento di recupero amministrativo eseguibile dal server.
La parte importante, per me, è che tutto rimane sotto il mio controllo e non devo dipendere da un servizio esterno per amministrare PostgreSQL.
Come collegarsi al server dopo la configurazione
A questo punto abbiamo un server con PostgreSQL e Supavisor, un dominio db.example.com, un certificato TLS per quel dominio e il firewall che consente l'accesso al pooler soltanto dai server applicativi autorizzati.
Per verificare tutto dalla macchina su cui girerà l'applicazione, non serve entrare via SSH sul server database. Uso direttamente psql con la verifica del certificato:
PGSSLMODE=verify-full \
PGSSLROOTCERT=/etc/my_app/tls/ca.crt \
psql \
  -h db.example.com \
  -p 6543 \
  -U demo_app.demo \
  -d demo_db \
  -W
Inserisco la password del tenant e provo:
SELECT current_database(), current_user;
Se questa query funziona, dal punto di vista della rete il client raggiunge Supavisor direttamente. Nella configurazione Ecto basta usare gli stessi parametri. La porta 6543 è quella transazionale; per le migration possiamo usare la 5452 con le stesse credenziali e lo stesso certificato.
Attenzione a una distinzione: la connessione diretta a PostgreSQL può essere configurata anche con autenticazione tramite certificato client, come in alcune mie applicazioni. Nel mio fork attuale, invece, il TLS in ingresso di Supavisor autentica il server ma non richiede automaticamente un certificato client: l'handshake usa verify: :verify_none lato server. Per questo servono anche le credenziali del tenant e regole firewall restrittive. Non basta copiare i certificati client utilizzati dal PostgreSQL originale.
Il tunnel SSH rimane un'alternativa, non un requisito. Se non ho un indirizzo di uscita stabile da autorizzare nel firewall, posso utilizzare una rete privata o una VPN. Ma con TLS e rete configurati correttamente, l'applicazione si collega direttamente al server.
Come eseguire le migration
Questo è un dettaglio che è meglio sistemare subito.
Per le normali query applicative posso usare il transaction pooling, purché l'applicazione non dipenda da funzionalità che richiedono una sessione persistente.
Le migration, invece, preferisco eseguirle tramite il pool di sessione o direttamente su PostgreSQL.
Con la configurazione Ecto mostrata prima, mi basta cambiare la modalità:
DATABASE_POOL_MODE=session
In un progetto Phoenix che utilizza la normale release con Demo.Release.migrate/0, posso eseguire:
DATABASE_POOL_MODE=session \
  bin/demo eval 'Demo.Release.migrate()'
La funzione Demo.Release.migrate/0 deve essere presente nella release; può essere generata o adattata utilizzando gli strumenti di Phoenix.
Per il normale traffico applicativo torno a:
DATABASE_POOL_MODE=transaction \
  bin/demo start
Non utilizzo il transaction pooling per operazioni che devono conservare stato tra transazioni, come determinate tabelle temporanee, LISTEN/NOTIFY, impostazioni di sessione o advisory lock legati alla sessione.
Questo è un limite normale di questo modello di pooling, non un problema specifico di Elixir.
E se ho già un database presso un provider?
Non devo necessariamente ricominciare da zero.
Per un database PostgreSQL esistente posso utilizzare pg_dump e pg_restore.
Per esempio, dopo aver verificato le credenziali e la compatibilità delle versioni:
pg_dump \
  "$OLD_DATABASE_URL" \
  --format=custom \
  --file=backup.dump
Creo prima il database di destinazione, poi ripristino i dati attraverso una connessione diretta a PostgreSQL:
pg_restore \
  --dbname="$NEW_DATABASE_URL_DIRECT" \
  --no-owner \
  --no-acl \
  --exit-on-error \
  backup.dump
In questo esempio NEW_DATABASE_URL_DIRECT deve puntare al nuovo PostgreSQL, non al pool transazionale. Le eventuali estensioni e i permessi richiesti vanno verificati prima del restore.
Questo è un esempio di trasferimento semplice, non una procedura di migrazione senza downtime.
Se la vecchia applicazione continua a scrivere durante il dump, devo pianificare il passaggio finale per evitare di perdere le modifiche successive allo snapshot.
Prima provo il ripristino su un database separato, controllo che schema e dati siano corretti, poi preparo il passaggio della connessione applicativa.
Soltanto quando sono sicuro che tutto funzioni elimino il vecchio servizio.
Non è proprio il momento ideale per scoprire che il backup era inutilizzabile.
Alla fine, ne vale la pena?
Per me sì.
Adesso posso utilizzare PostgreSQL per diversi progetti senza dover acquistare continuamente un nuovo database gestito.
Posso amministrare database e tenant dalla dashboard, controllare connessioni e metriche, creare backup e decidere quando aumentare le risorse.
E la parte che mi piace di più è che Supavisor è scritto in Elixir.
Ho potuto prendere un progetto open source già esistente, studiarlo e aggiungere le funzionalità che mi mancavano, senza costruire da zero un connection pooler PostgreSQL.
Naturalmente non è tutto gratis.
Adesso devo occuparmi io degli aggiornamenti, della disponibilità del server, della sicurezza e soprattutto dei backup. Un backup conservato sulla stessa macchina non mi protegge dalla perdita di quella macchina: servono anche copie esterne e prove di ripristino.
Inoltre un solo server rimane un singolo punto di guasto. Il pooling migliora la gestione delle connessioni, ma non rende PostgreSQL automaticamente distribuito né aumenta da solo la CPU disponibile.
Per applicazioni grandi o critiche, un servizio gestito può assolutamente valere il prezzo richiesto.
Però per il mio modo di lavorare, con tanti progetti piccoli e applicazioni in continua evoluzione, questa soluzione ha molto più senso.
E devo dire che sono abbastanza soddisfatto anche del risultato della dashboard.
Tutto è cominciato perché mi ero stancato di pagare cifre assurde per un PostgreSQL che, in parecchi casi, doveva soltanto conservare pochi dati.
Adesso ho il mio server, il mio connection pooler e una console LiveView per gestire tutto.
Magari un giorno uno dei miei progetti crescerà così tanto da aver bisogno di un cluster dedicato e di un'infrastruttura più complessa.
Benissimo.
Sarà anche una bella notizia.
Ma almeno, fino a quel momento, posso continuare a sviluppare senza dover aggiungere un altro abbonamento ogni volta che mi viene in mente un'idea.
E visto quante idee mi vengono, direi che era ora.