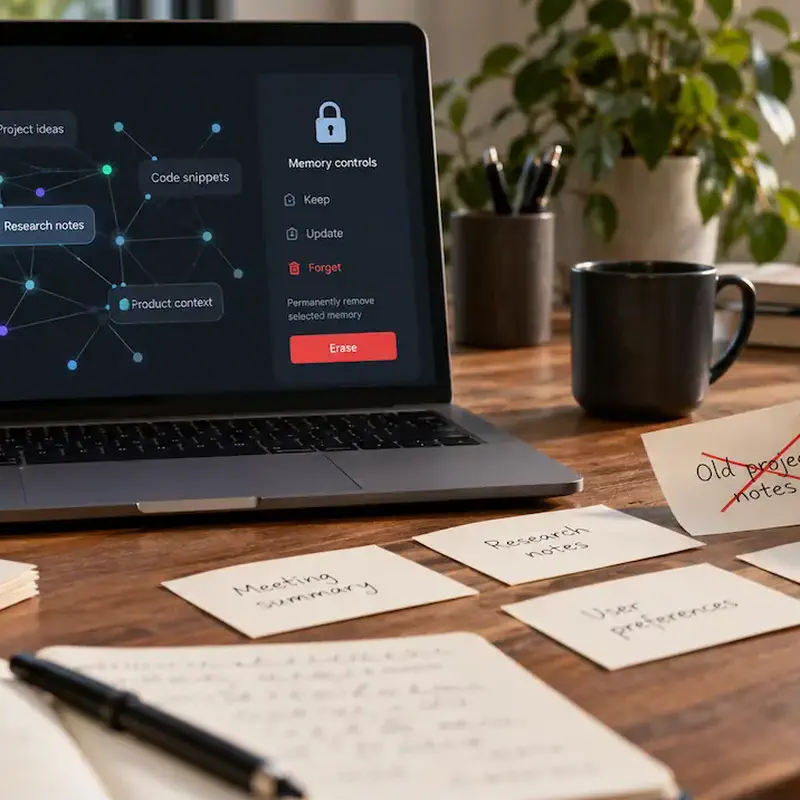
Una delle cose che mi interessavano di più mentre costruivo Spectre Mnemonic era dare agli agenti una memoria che non fosse semplicemente una lista infinita di messaggi.
Volevo poter collegare informazioni, recuperare un contesto, consolidare quello che vale la pena conservare e lasciare perdere il resto.
Per questo Mnemonic utilizza ETS per la memoria attiva, un grafo di associazioni e storage persistente per i ricordi più durevoli.
Il problema è che più rappresentazioni aggiungi, più diventa complicata un'operazione apparentemente semplicissima: eliminare un'informazione.
Non basta più rimuovere una riga.
Il problema nasce dalla stessa architettura che rende utile la memoria
Una informazione può generare un momento, delle associazioni, una sintesi e magari un embedding.
Quando chiedo alla memoria di recuperare qualcosa, non cerco necessariamente soltanto il testo originale. Posso arrivarci attraverso le associazioni oppure una ricerca semantica.
Questo è esattamente il comportamento che volevo.
Ma se quella informazione non deve più esistere?
Eliminare soltanto il momento attivo non basta. Potrebbe essere già stato salvato nello storage durevole. Potrebbero esistere rappresentazioni derivate. E un riavvio potrebbe ricostruire parte dello stato leggendo il registro persistente.
Mi sono reso conto che dovevo distinguere due operazioni che sembrano uguali soltanto dal punto di vista dell'utente: smettere di usare un ricordo ed eliminare fisicamente i dati che lo rappresentano.
Per la prima ho utilizzato una forma di cancellazione logica.
opts = [
  scope: {:project, "checkout"},
  namespace: "my_app_memory"
]

{:ok, %{moment: moment}} =
  SpectreMnemonic.signal(
    "Il checkout utilizza il provider A",
    opts ++ [persist?: true]
  )

{:ok, count} =
  SpectreMnemonic.forget(moment.id, opts)
La memoria viene resa logicamente indisponibile. Nello storage append-only, però, i byte dei vecchi record possono ancora esistere fino alla compattazione.
Per registrare che un dato non deve più essere considerato, posso usare delle tombstone: marcatori che invalidano logicamente ciò che è stato scritto in precedenza.
Mi piace questa soluzione perché non costringe a riscrivere continuamente lo storico.
Però risolve soltanto metà del problema.
Il test che considero più importante non cancella niente all'inizio
C'è un caso di concorrenza che mi interessa particolarmente.
Un processo sta eliminando i ricordi di un account. Un altro processo, nello stesso momento, sta tentando di aggiungere una nuova informazione alla medesima partizione.
Entrambi possono essere perfettamente legittimi dal loro punto di vista.
Ma l'ordine delle operazioni è fondamentale.
Processo A               Processo B

inizia cancellazione
                         prepara una scrittura
elimina i vecchi dati
termina
                         salva il vecchio evento
Se permetto questa sequenza, l'informazione che ho appena cancellato può ricomparire immediatamente.
E non è un problema che risolvo aggiungendo un'altra DELETE alla fine. Potrebbero arrivare altre scritture in ritardo.
Mi serviva un confine più forte: una volta cancellata una partizione, le operazioni concorrenti non devono poterla ricreare per errore.
In Mnemonic ho introdotto una cancellazione esplicita della partizione:
{:ok, report} =
  SpectreMnemonic.erase_partition(
    namespace: "my_app_memory",
    scope: {:subject, "account-42"},
    sealed: true
  )
Con sealed: true la partizione viene chiusa anche alle nuove scritture.
La cancellazione fisica richiede che i backend di persistenza configurati possano effettuarla e verificarla. Se non possono garantire questa operazione, non devono fingere che abbia funzionato.
Provare a far fallire il sistema nel momento peggiore
Nel repository ho un test di regressione dedicato proprio a questa situazione.
Uso un punto di iniezione per fermare temporaneamente la cancellazione mentre è in corso. A quel punto lancio, da un'altra Task, una scrittura sulla stessa partizione.
Soltanto dopo lascio terminare la cancellazione.
Il comportamento che verifico è che la scrittura rimasta in attesa venga rifiutata:
assert {:ok, report} =
         Task.await(erasure, 10_000)

assert report.compaction == :erased

assert {:error, :partition_erased} =
         Task.await(stale_write, 5_000)
erasure e stale_write sono le due task preparate dal test.
Mi interessava verificare non solo che i dati sparissero, ma che una scrittura concorrente non potesse riportarli indietro.
Anche il replay dello storage deve rispettare il risultato: i record eliminati non devono ricomparire, mentre il marcatore della partizione chiusa continua a impedire nuove operazioni.
Questo tipo di test mi sembra molto più utile che limitarmi a verificare delete → get == nil.
Quest'ultimo dimostra che ho cancellato qualcosa in un momento preciso. Non dimostra che il sistema rimanga corretto mentre altri processi stanno lavorando.
Un altro dettaglio che mi ha fatto ragionare: quando un ricordo diventa vecchio?
Non tutte le informazioni devono essere cancellate esplicitamente da un utente.
Alcune semplicemente smettono di essere valide.
Mnemonic supporta valid_from e valid_until, ma anche qui bisogna decidere che cosa significa esattamente una data.
Se un ricordo è valido fino al 25 agosto, deve sparire alle 00:00 del 25 oppure rimanere valido fino alla fine della giornata?
Nel motore temporale ho scelto intervalli con limite finale escluso. Quando valid_until è un valore Date, viene normalizzato alle 00:00 UTC del giorno successivo, non alla mezzanotte del fuso locale dell'utente.
Quindi:
valid_until: ~D[2026-08-25]
Significa che l'informazione è ancora valida il 25 agosto alle 23:59:59 UTC, ma non più dalle 00:00 UTC del 26 agosto. Se l'applicazione usa un altro fuso orario, deve gestire esplicitamente la conversione.
È una decisione piccola, ma rende il comportamento prevedibile e verificabile nei test.
E il GDPR?
Qui preferisco non raccontare favole.
Eliminare una partizione dentro Mnemonic non significa automaticamente cancellare tutte le copie che potrebbero essere finite in backup esterni, log, esportazioni o provider AI.
La libreria può offrire controlli tecnici verificabili sul proprio storage. L'applicazione deve però occuparsi anche del resto.
La cosa che mi ha colpito lavorando su Mnemonic è quanto sia facile progettare la memoria pensando soltanto all'inserimento e al recupero delle informazioni.
Aggiungere memoria è relativamente semplice. Gestirne il ciclo di vita è molto più delicato.
E soprattutto, in un sistema concorrente come BEAM, cancellare un'informazione non è sufficiente: bisogna fare in modo che nessun processo possa rimetterla al suo posto quando non dovrebbe più esistere.